¡Nuestra experiencia tiene dos direcciones! Para descubrir el mundo de los Espacios de Colaboración y Reunión:
Un servidor que deja de responder, un enlace de fibra cortado, una aplicación de negocio que va cada vez más lenta: en la mayoría de las organizaciones, este tipo de incidencias se detectan, se diagnostican y se resuelven desde un NOC, o Network Operations Center. Este centro de supervisión de red vigila de forma continua las infraestructuras informáticas y de telecomunicaciones, y muchas veces actúa antes de que los usuarios lleguen a notar el problema. Ahora bien, detrás de estas siglas caben realidades muy distintas: desde un equipo de tres personas en una oficina hasta una sala de control operativa las 24 horas, con videowalls y puestos multipantalla. Entender qué es un NOC, en qué se diferencia de un SOC y qué lo hace eficaz ayuda a plantear mejor cualquier proyecto.
Lo esencial
El NOC es un espacio, físico o virtual, desde el que un equipo de ingenieros y técnicos vigila el estado de las redes y los sistemas de una organización. También se le llama centro de supervisión de red, centro de operaciones o centro de gestión de red. Su alcance abarca los equipos de red (routers, switches, firewalls, enlaces WAN), los servidores, el almacenamiento y las aplicaciones críticas. En el caso de los operadores, se extiende además a las redes de telecomunicaciones o satelitales.
Los primeros NOC nacieron en los operadores de telecomunicaciones. Hoy también están presentes en proveedores de alojamiento, centros de datos, proveedores de servicios gestionados y grandes empresas. Las administraciones públicas y los gestores de infraestructuras críticas, como la energía o el transporte, también cuentan con ellos.
Cualquier organización cuya actividad dependa de una red disponible en todo momento. Un operador de telecomunicaciones supervisa miles de equipos repartidos por un territorio. Un hospital debe garantizar el acceso a las historias clínicas y a los equipos médicos conectados. Una empresa industrial vigila las redes que conectan sus centros de producción. Y un proveedor de servicios gestionados opera el NOC en nombre de sus clientes, con compromisos contractuales de nivel de servicio.
Las necesidades varían mucho según el tamaño del parque y las exigencias de disponibilidad. Algunas organizaciones se conforman con una supervisión en horario laboral. Otras exigen presencia humana 24/7, con tiempos de respuesta de pocos minutos.
La supervisión es el núcleo del trabajo. Las herramientas recopilan sin interrupción métricas (disponibilidad, latencia, ancho de banda, carga de CPU, espacio en disco) y registros de eventos. Cuando se supera un umbral, salta una alarma que llega a los operadores. El objetivo es detectar un problema incipiente antes de que se convierta en una caída visible.
No toda alarma es una incidencia. El operador de nivel 1 comprueba, correlaciona los eventos y determina el impacto real. Si el problema supera su ámbito, lo escala al nivel 2 o 3, a un experto o a un proveedor. Esta organización por niveles, a menudo inspirada en las buenas prácticas de ITIL, evita dedicar recursos escasos a incidencias sencillas.
El NOC no se limita a reaccionar. Planifica las ventanas de mantenimiento, despliega parches, sigue la capacidad de la red y elabora informes de disponibilidad. Los indicadores más habituales son el MTTD (tiempo medio de detección), el MTTA (tiempo medio de atención) y el MTTR (tiempo medio de resolución). Permiten medir la eficacia del centro a lo largo del tiempo.
Ante una incidencia grave, el NOC se convierte en el punto de coordinación. Informa a los equipos de negocio, a los clientes y a la dirección, y lleva el registro de todas las acciones. Una comunicación clara reduce el número de llamadas entrantes y permite que los técnicos se concentren en resolver el problema.
El coste de las interrupciones del servicio explica el peso que han ganado estos centros. Según el Uptime Institute, el 57 % de los participantes en su encuesta anual de 2025 afirma que su última caída grave costó más de 100 000 dólares. Por segundo año consecutivo, una de cada cinco organizaciones declara un coste superior al millón de dólares. (fuente: Uptime Institute, Annual Outage Analysis 2026, mayo de 2026).
En las grandes empresas, la factura se dispara. Splunk y Oxford Economics encuestaron a 2000 directivos de compañías del Global 2000. Su estudio calcula que las paradas imprevistas cuestan 400 000 millones de dólares al año, unos 200 millones por empresa y cerca del 9 % de sus beneficios. Cada minuto de interrupción cuesta de media 9000 dólares. (fuente: Splunk y Oxford Economics, The Hidden Costs of Downtime, junio de 2024).
El mismo informe del Uptime Institute deja otra conclusión muy reveladora para un NOC. El incumplimiento de los procedimientos establecidos sigue siendo la primera causa de las caídas atribuibles a errores humanos. Además, las incidencias relacionadas con la fibra y la conectividad van en aumento, con interrupciones más largas. Dicho de otro modo, la calidad de los procesos y las condiciones de trabajo de los operadores pesan tanto como la propia tecnología.
Los centros de supervisión tienen nombres parecidos y sus fronteras no siempre están claras. La siguiente tabla aclara el papel de cada uno.
| Centro | Objetivo principal | Qué supervisa | Indicadores clave |
|---|---|---|---|
| NOC (Network Operations Center) | Disponibilidad y rendimiento | Redes, servidores, aplicaciones, enlaces de telecomunicaciones | Disponibilidad, MTTR, cumplimiento de SLA |
| SOC (Security Operations Center) | Detección y respuesta ante amenazas | Eventos de seguridad, comportamientos sospechosos | Tiempo de detección, tiempo de contención |
| Centro de hipervisión | Visión unificada y control global | Agregación de herramientas de supervisión técnicas y de negocio | Impacto en el negocio, correlación de incidencias |
| Help desk / service desk | Soporte a usuarios | Solicitudes e incidencias comunicadas por los usuarios | Tiempo de respuesta, satisfacción |
El NOC se pregunta si el servicio funciona. El SOC se pregunta si está siendo atacado. Una saturación del ancho de banda puede deberse a un pico de actividad legítimo, y entonces le corresponde al NOC. Pero también puede ser la señal de un ataque de denegación de servicio, que ya es cosa del SOC. Por eso ambos equipos deben compartir información en tiempo real.
Algunas organizaciones sitúan los dos centros uno junto al otro, o incluso los fusionan en un mismo espacio. Así se facilita la coordinación durante las incidencias graves, aunque obliga a gestionar con precisión los permisos de acceso y a separar claramente las responsabilidades. La decisión depende del tamaño de los equipos, del nivel de madurez y de los requisitos normativos, sobre todo en el caso de los operadores de infraestructuras críticas. En el ámbito de la seguridad, la elección de herramientas responde a otra lógica, que se explica en el artículo SOC: elegir las herramientas adecuadas.
Cuando una organización acumula varias herramientas de supervisión, los operadores acaban saltando de una consola a otra. La hipervisión agrupa todas esas fuentes en una única vista, correlaciona los eventos y traduce las alarmas técnicas en impacto para el negocio. En un NOC, reduce el ruido y acelera la identificación de la causa raíz.
Las plataformas de supervisión de red recogen los datos mediante SNMP, flujos NetFlow, registros syslog o agentes instalados en los servidores. El mercado ofrece soluciones muy diversas: Centreon, Zabbix, Checkmk, PRTG, SolarWinds o ManageEngine, por citar solo las más extendidas. La elección depende del tamaño del parque, del modelo de licencia, de la capacidad de integración y de las competencias internas.
Los enfoques de observabilidad van un paso más allá. Cruzan métricas, registros y trazas de aplicación para entender cómo se comporta un sistema complejo, y no solo en qué estado se encuentra. En la práctica, las señales débiles que anuncian una caída suelen ser visibles mucho antes de la incidencia. El artículo Supervisión de red: lo que marca la diferencia sobre el terreno repasa estos indicadores. El tema también se desarrolla en el artículo dedicado a la supervisión del parque informático.
Una herramienta de ticketing registra cada incidencia desde su detección hasta su cierre. Estructura el escalado, conserva el historial y alimenta los informes de nivel de servicio. Las bases de conocimiento asociadas permiten que los operadores de nivel 1 resuelvan más incidencias sin necesidad de escalarlas.
En un centro de datos, el NOC también vigila la energía, la refrigeración y la ocupación de los racks. Las herramientas DCIM (Data Center Infrastructure Management) tienden un puente entre la informática y el edificio. No es un detalle menor: según el Uptime Institute, el suministro eléctrico sigue siendo la primera causa de las caídas de mayor impacto.
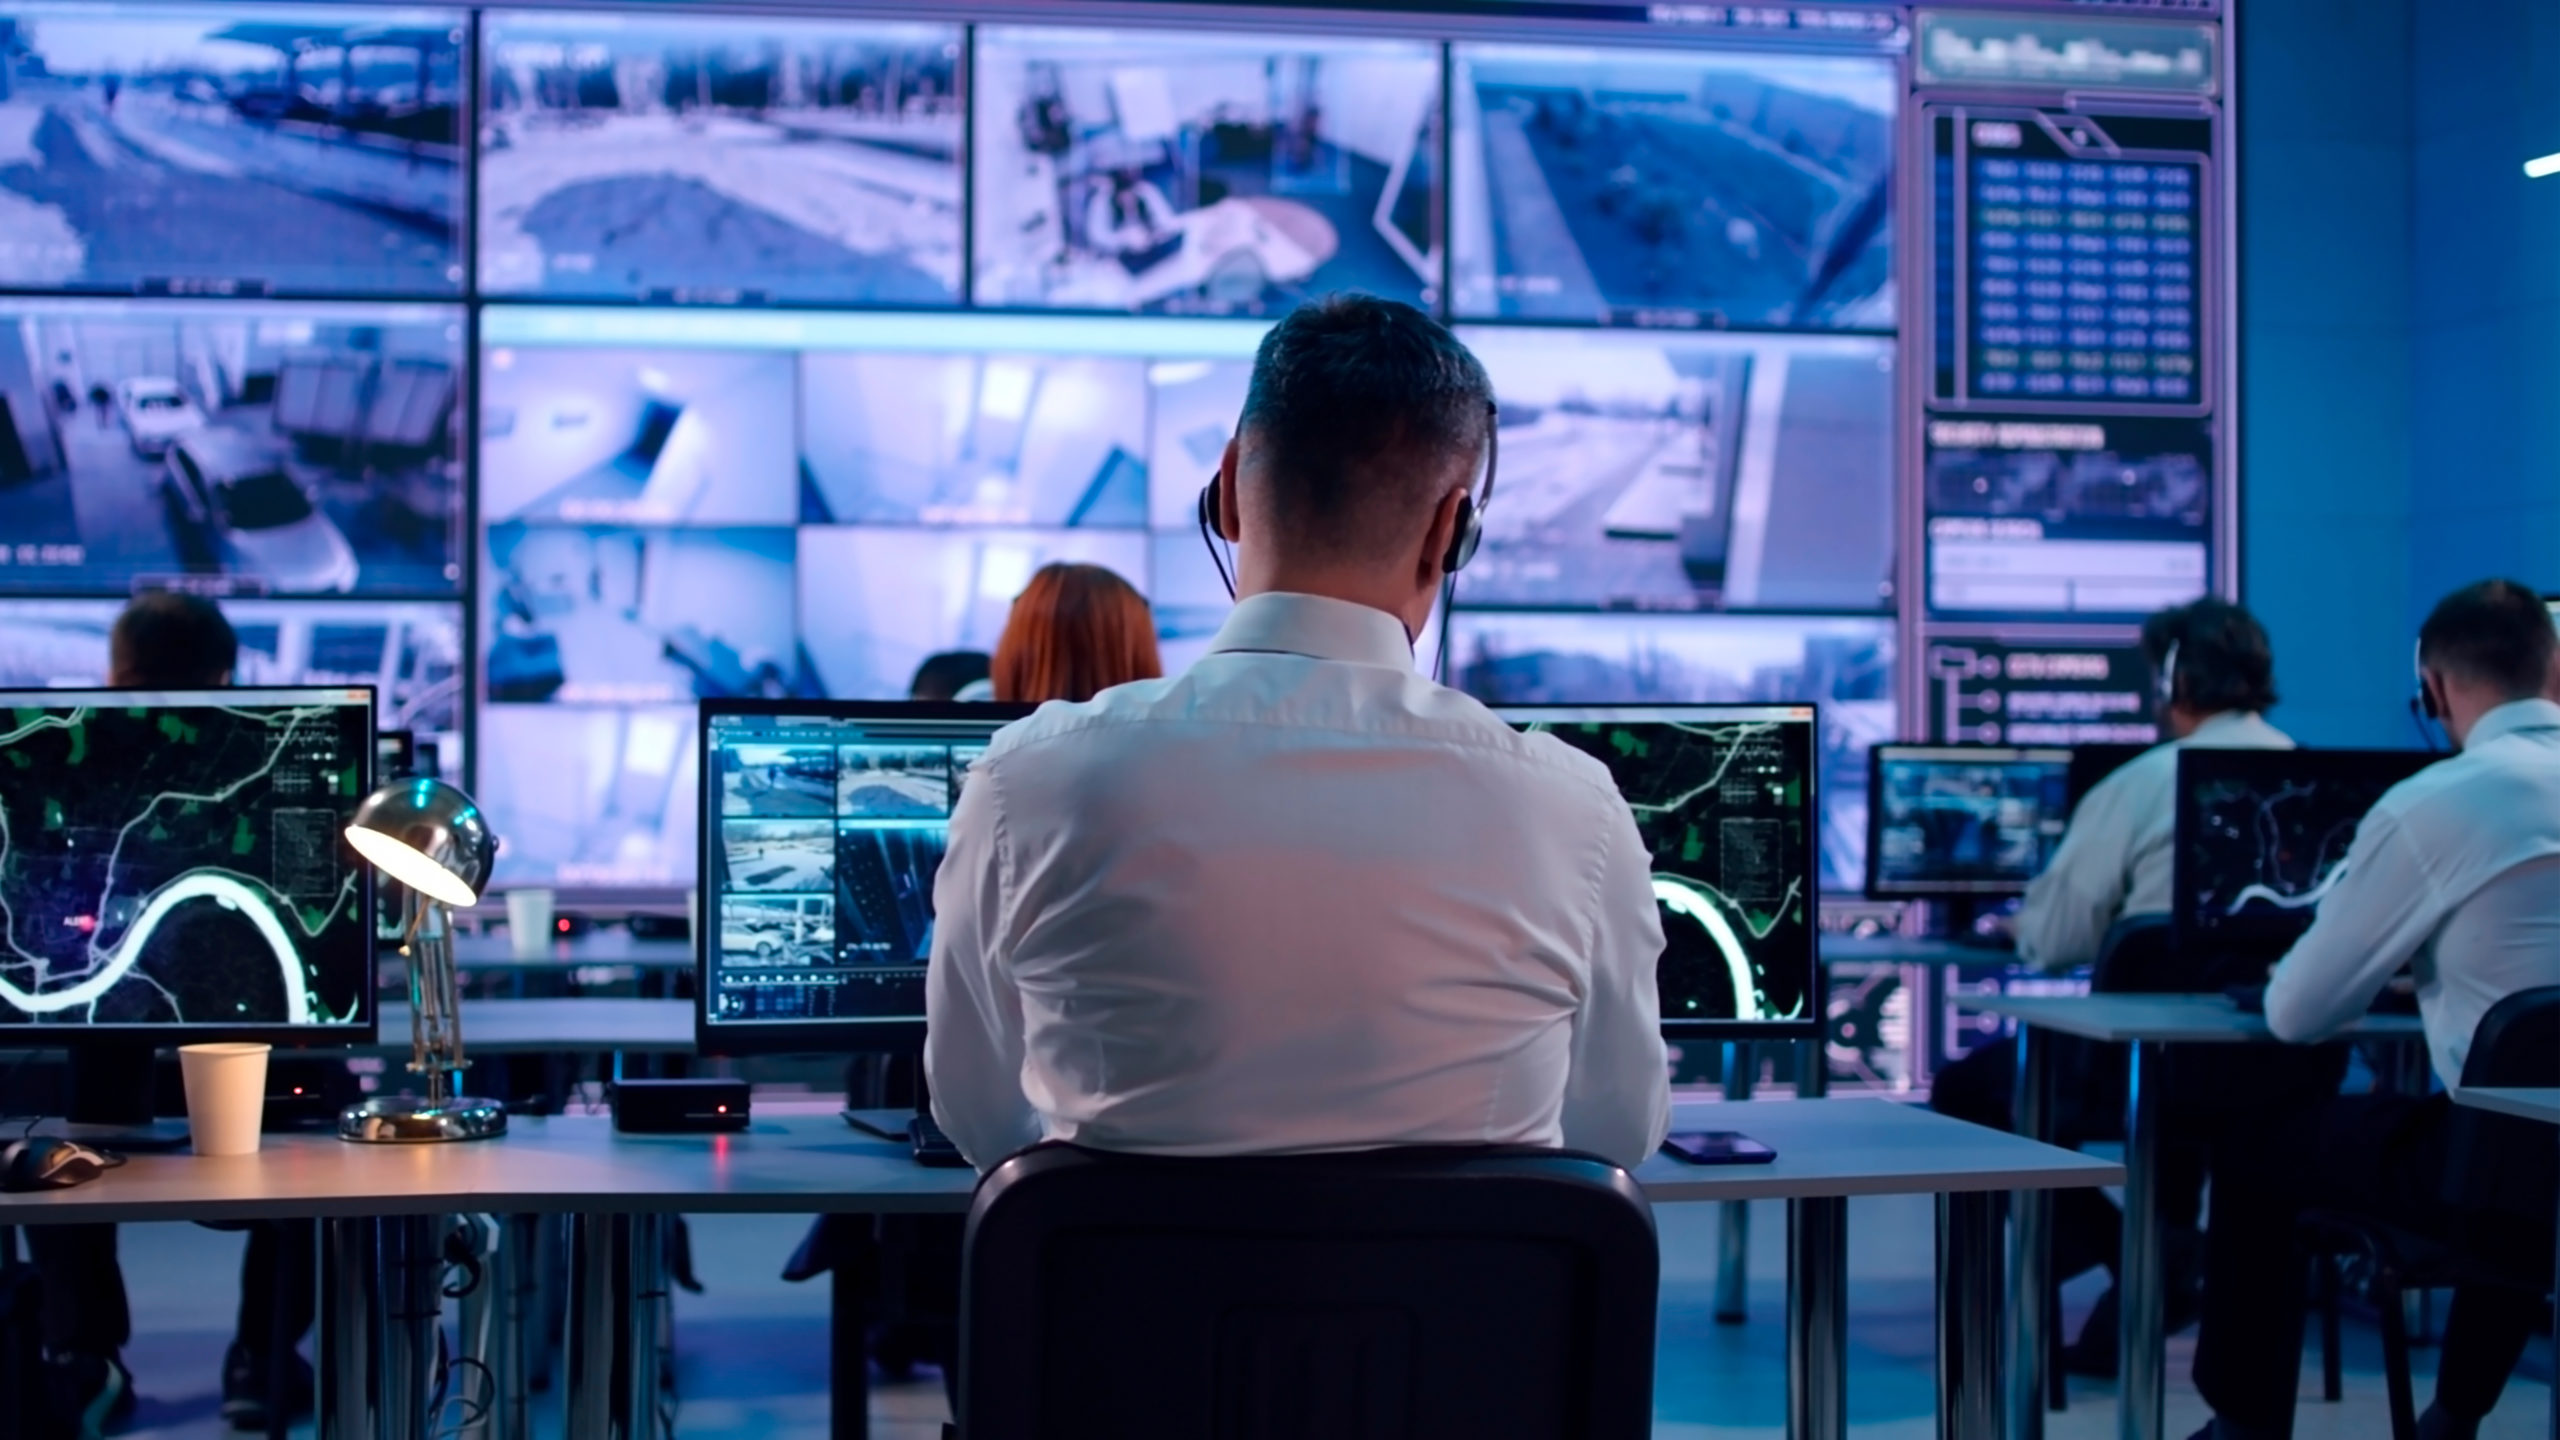
Un NOC operativo las 24 horas es una sala de control en toda regla. Los operadores pasan horas interpretando información crítica, a veces bajo presión. El diseño del espacio influye, por tanto, directamente en su nivel de atención y en su capacidad de reacción.
Tres elementos vertebran la mayoría de los proyectos. El videowall muestra lo que todo el equipo necesita ver a la vez: el mapa de la red, las alarmas graves y los cuadros de mando de disponibilidad. Los puestos de operador multipantalla, a menudo conectados mediante una solución KVM, dan acceso a las consolas de supervisión sin llenar la sala de equipos. Por último, la ergonomía, regulada por la norma ISO 11064, abarca la distribución, la iluminación, la acústica y un mobiliario técnico pensado para un uso continuo.
El aspecto que más se subestima sigue siendo la gestión de alarmas. Cuando una pantalla muestra cientos de avisos menores, la alarma crítica puede pasar desapercibida. Un buen diseño jerarquiza las alertas y reserva el videowall para los eventos que exigen una actuación conjunta. Los principios de ergonomía de las salas de control explican estas decisiones en detalle.
Un operador de red regional supervisa varios miles de equipos repartidos en un centenar de emplazamientos. Su antiguo centro se reducía a unas oficinas convencionales y unos cuantos televisores colgados en la pared. Los operadores saltaban de una consola a otra, y las incidencias graves se coordinaban por teléfono.
El nuevo NOC gira en torno a un videowall que muestra el mapa de la red y las alarmas críticas. Seis puestos de operador multipantalla se sitúan frente a él, con un puesto de jefe de sala ligeramente elevado. Una sala de crisis contigua acoge al comité de crisis durante las incidencias graves. La mejora más visible no tiene que ver con la tecnología: ahora todos ven la misma información en el mismo momento.
Diseñar un NOC requiere combinar varias especialidades: análisis de usos, ergonomía, audiovisual, mobiliario técnico e integración de las herramientas de supervisión. Motilde acompaña a las organizaciones en todos estos ámbitos, desde la auditoría de la supervisión existente hasta la construcción del espacio de control. La página dedicada al diseño de salas NOC ofrece una guía experta a las organizaciones que preparan un proyecto. En ella se abordan la estructura de los equipos, los indicadores clave, el diseño de la sala y las herramientas de supervisión.
AIOps y automatización. Las plataformas de AIOps aplican la inteligencia artificial a la correlación de eventos. Agrupan las alertas que comparten una misma causa y sugieren acciones correctivas. Algunas tareas recurrentes, como reiniciar un servicio, ya están automatizadas. Aun así, el Uptime Institute recuerda que una mayor automatización también puede generar nuevos tipos de incidencias.
La convergencia NOC-SOC. Algunas amenazas, como el ransomware, afectan directamente a la disponibilidad. Ante ellas, cada vez más organizaciones acercan sus equipos de red y de seguridad.
Una dependencia externa cada vez mayor. Nube pública, enlaces de operadores, servicios SaaS: una parte creciente de las incidencias se origina fuera del perímetro de la empresa. Por eso el NOC también debe supervisar a sus proveedores.
NOC híbridos. Los equipos combinan una sala física para las operaciones críticas con acceso remoto para las guardias. La sala sigue siendo el lugar de referencia en situaciones de crisis, cuando la coordinación presencial marca la diferencia.
NOC significa Network Operations Center, es decir, centro de operaciones de red. Designa el lugar desde el que un equipo supervisa, administra y mantiene las redes y la infraestructura informática de una organización. Este centro puede ser interno o estar externalizado en un proveedor de servicios gestionados.
El NOC garantiza la disponibilidad y el rendimiento de las redes y los sistemas. El SOC, o Security Operations Center, detecta y gestiona las amenazas de ciberseguridad. A veces ambos centros supervisan los mismos equipos, pero con objetivos distintos. Colaboran estrechamente en las incidencias que combinan una caída y un ataque.
Un NOC suele reunir a operadores o técnicos de supervisión de nivel 1, ingenieros de redes y sistemas de niveles 2 y 3, y un responsable o jefe de sala. Según el tamaño del centro, también puede haber especialistas en herramientas de supervisión y gestores de la relación con los proveedores.
No necesariamente. Todo depende de los compromisos de servicio y de lo críticas que sean las infraestructuras. Los operadores de telecomunicaciones, los proveedores de alojamiento y las infraestructuras críticas suelen funcionar de forma continua. Otras organizaciones combinan presencia durante el día con guardias remotas por la noche, mientras una supervisión automatizada se encarga de lanzar las alertas.
La sala de un NOC suele incluir un videowall para la información compartida y puestos de operador multipantalla. A ello se suman una solución KVM para controlar las fuentes, un mobiliario técnico pensado para un uso continuo y una alimentación de respaldo. La ergonomía, la iluminación y la acústica completan el conjunto para mantener la atención de los operadores. Las soluciones de diseño de salas NOC detallan estas opciones según el tamaño y el nivel de exigencia del centro.
La externalización encaja con las organizaciones que no disponen de las competencias o la plantilla necesarias para una supervisión continua. Ofrece una cobertura 24/7 con un coste controlado. Un NOC interno, en cambio, conserva la ventaja de conocer a fondo los sistemas y de estar cerca de los equipos de negocio. Muchas organizaciones optan por un modelo mixto.
El NOC es el centro neurálgico de la disponibilidad digital. Al supervisar de forma continua redes, servidores y aplicaciones, reduce la duración y el impacto de unas incidencias cuyo coste no deja de crecer. Su rendimiento se basa en el equilibrio entre herramientas de supervisión, procesos rigurosos y unas condiciones de trabajo adecuadas.
En los próximos años, la AIOps, la convergencia con la ciberseguridad y la supervisión de las dependencias externas deberían redefinir el papel del Network Operations Center. Los operadores dedicarán menos tiempo a clasificar alertas y más a tomar decisiones. La sala seguirá siendo entonces el lugar donde la información se convierte en acción.
Copyright © 2026. MOTILDE. All rights reserved.