¡Nuestra experiencia tiene dos direcciones! Para descubrir el mundo de los Espacios de Colaboración y Reunión:
Las redes casi nunca fallan de golpe. Antes suele haber avisos, aunque sean discretos: errores CRC que se van acumulando en un puerto, un enlace WAN que va siempre al límite, un switch cuya memoria lleva tres semanas subiendo sin hacer ruido. La monitorización de redes está para detectar esas señales a tiempo y actuar en consecuencia. En teoría, no tiene misterio. En la práctica, muchas empresas tienen una herramienta de monitorización perfectamente instalada y, aun así, se enteran de las caídas cuando un usuario llama quejándose.
Puntos clave
La monitorización de redes consiste en vigilar de forma continua el estado y el rendimiento de la infraestructura de comunicaciones. Routers, switches, cortafuegos, puntos de acceso wifi, enlaces de operador: todo lo que mueve datos entra en juego.
En los últimos diez años, ese perímetro ha crecido muchísimo. Hoy una empresa mediana tiene que estar pendiente de sus enlaces SD-WAN, de los túneles hacia la nube, de los accesos remotos y, a veces, también de su red industrial. En una fábrica o en una terminal portuaria, un mismo operador puede encargarse a la vez de un núcleo de red Ethernet y de equipos OT que nunca se pensaron para ser monitorizados. Y es justo ahí donde los proyectos suelen torcerse.
Es habitual usar estos términos como si significaran lo mismo, pero no es así, y esa confusión acaba provocando malentendidos en los pliegos de condiciones.
La monitorización básica se limita a medir y a comparar los valores con unos umbrales. La supervisión va más allá: lanza alertas, guarda un histórico y ayuda a diagnosticar. La observabilidad intenta entender por qué un sistema se comporta como lo hace, cruzando métricas, logs y trazas de las aplicaciones. Y la hipervisión está por encima de todo esto: agrupa varias herramientas de monitorización en una única vista, pensada en términos de servicios de negocio.
En las grandes organizaciones conviven los cuatro niveles. La cuestión no es quedarse con uno, sino tener claro cuál responde a cada pregunta.
Durante mucho tiempo, la monitorización de redes fue cosa de técnicos. Las cifras más recientes explican por qué ahora la dirección también le presta atención.
Según New Relic, una caída de alto impacto tiene un coste mediano de 2 millones de dólares por hora, es decir, unos 33.333 dólares por minuto (fuente: New Relic, 2025 Observability Forecast). El informe incluye además un dato muy revelador: las organizaciones con observabilidad completa reducen ese coste a la mitad y detectan las incidencias 7 minutos antes, con un tiempo medio de detección de 28 minutos (fuente: New Relic). Si cada minuto de caída cuesta dinero, siete minutos marcan una diferencia enorme.
En los centros de datos el panorama es parecido. El 54 % de los encuestados por Uptime Institute asegura que su última caída grave costó más de 100.000 dólares, y uno de cada cinco habla de más de un millón (fuente: Uptime Institute, Annual Outage Analysis 2025).
Ese mismo informe de Uptime Institute indica que en 2024 aumentaron las caídas relacionadas con sistemas y redes, hasta representar el 23 % de las que tuvieron impacto (fuente: Uptime Institute). Los autores lo achacan a una complejidad cada vez mayor, que multiplica los errores de configuración y los cambios que se escapan de control.
Cualquiera que trabaje en operaciones lo ha vivido. Alguien toca una regla del cortafuegos o lanza una actualización de firmware un viernes por la tarde, y de repente toda una sede se queda sin acceso a una aplicación. Una buena monitorización no evita el error, pero sí reduce drásticamente el tiempo que se tarda en verlo.
La Directiva NIS2 (UE) 2022/2555 ha ampliado mucho la lista de organizaciones obligadas a cumplir requisitos de ciberseguridad. Una de esas obligaciones es notificar los incidentes significativos: un primer aviso en menos de 24 horas y una notificación detallada en menos de 72. Sin datos de red fiables, con marca de tiempo y bien conservados, cumplir esos plazos es complicado.
Todo empieza por la recogida de datos. El ping sigue siendo lo primero que se usa, pero solo confirma una cosa: que el equipo responde. No avisa de que un enlace esté saturado ni de que un servicio esté empeorando.
El grueso del trabajo se hace con SNMP, que consulta los contadores internos de cada equipo. Aquí hay dos cosas que conviene hacer bien. La primera, pasarse a SNMPv3, que cifra y autentica las comunicaciones; en las auditorías todavía aparecen comunidades «public» que llevan años activas. La segunda, usar contadores de 64 bits en las interfaces rápidas. En un enlace de 10 Gbit/s, un contador de 32 bits se reinicia en cuestión de segundos y las gráficas de tráfico que genera no sirven para nada.
Para saber quién se está comiendo el ancho de banda, hace falta además analizar los flujos con NetFlow, IPFIX o sFlow. Los logs de Syslog completan el cuadro y son imprescindibles para reconstruir paso a paso lo que ha pasado en una incidencia. Y los equipos más modernos ya pueden enviar sus datos de forma continua mediante telemetría en streaming, con un nivel de detalle al que ningún sondeo periódico llega.
Hay un error que se repite constantemente: querer monitorizarlo todo. Al final, uno acaba con paneles llenos de gráficas que nadie mira.
Los equipos con experiencia lo hacen al revés. Empiezan por lo esencial: la disponibilidad de los equipos y servicios críticos, el uso de los enlaces, la latencia y la pérdida de paquetes. Poco después suman los errores de interfaz, que muchas veces son el primer indicio de un cable en mal estado, un módulo óptico que empieza a fallar o un dúplex mal configurado. En voz y vídeo, lo prioritario es el jitter: una videoconferencia puede volverse imposible aunque el enlace vaya a la mitad de su capacidad.
Ojo también con las medias, porque engañan. Con un sondeo cada cinco minutos, un enlace puede aparecer al 40 % cuando en realidad se satura con microrráfagas de unos pocos segundos. Los usuarios se quejan de que todo va lento, las gráficas siguen en verde y nadie quiere hacerse cargo. Cuando los indicadores y lo que vive el usuario no cuadran, suele ser señal de que toca revisar la monitorización.
Una alerta solo sirve si alguien hace algo al recibirla. Los umbrales fijos, del tipo «80 % de uso», se configuran en un momento, pero enseguida generan ruido. Que el enlace de las copias de seguridad esté al 95 % cada noche a las dos de la madrugada no es una incidencia. Es lo normal.
La correlación es la otra pieza clave. Si cae el router de una sede remota, los cuarenta equipos que cuelgan de él dejan de responder. Sin dependencias configuradas, el operador recibe cuarenta y una alertas. Con ellas, recibe una sola: la que de verdad importa. Para eso hace falta tener la cartografía de red al día, algo que se descuida con demasiada frecuencia.
El mercado se reparte entre dos grandes grupos. Por un lado están los fabricantes comerciales, con suites muy completas como SolarWinds, ManageEngine, Progress WhatsUp Gold o Paessler PRTG. Por otro, las soluciones que nacieron en el open source, como Centreon, Checkmk, Zabbix o Nagios, que suelen tener una edición gratuita y otra de pago con soporte.
Curiosamente, las diferencias más importantes no están donde uno pensaría. Todas estas herramientas saben consultar un switch por SNMP. Lo que de verdad las separa es su arquitectura, lo que cubren y cómo se amplían con módulos.
| Solución | Perfil | Puntos fuertes | Conviene saber |
|---|---|---|---|
| SolarWinds | Suite muy completa, con raíces en el mundo de las redes | Diagnóstico avanzado (mapas con histórico, análisis de rutas, DPI), escala muy bien, módulos de NetFlow, gestión de configuraciones, IPAM y control de puertos | Tiene muchos módulos, así que hay que planificar bien presupuesto y arquitectura desde el principio |
| ManageEngine OpManager | Suite ITOM de Zoho | Muchos módulos integrados (NetFlow, configuraciones, cortafuegos, servidores), amplia biblioteca de plantillas con umbrales ajustables | Interfaz muy cargada que cuesta un poco dominar |
| WhatsUp Gold (Progress) | Pensada para que el día a día sea sencillo | Navegación intuitiva por niveles, fácil de probar métricas, módulos de NetFlow, configuraciones, logs y wifi | Cubre menos aplicaciones que las suites más grandes |
| PRTG (Paessler) | Todo en uno, con licencia por sensores | Se instala rápido, los mapas se crean con facilidad, se actualiza sola | El precio sube a medida que se añaden sensores, módulos avanzados más limitados |
| Solución | Perfil | Puntos fuertes | Conviene saber |
|---|---|---|---|
| Centreon | Fabricante francés, con edición libre y comercial | Muchísimos conectores, ideal para entornos grandes y distribuidos | La configuración avanzada es exigente |
| Checkmk | Fabricante alemán, con edición libre y comercial | Detecta los servicios automáticamente y permite incorporar muchos equipos en poco tiempo | Su forma de configurarse tiene su propia lógica, y hay que aprenderla |
| Zabbix | Totalmente open source | Muy completo, sin coste de licencia, con una comunidad muy activa | Curva de aprendizaje pronunciada |
| Nagios | El pionero, con versión libre y Nagios XI de pago | Se amplía fácilmente con plugins y es la base de muchas otras herramientas | Interfaz anticuada y configuración bastante manual |
| LibreNMS | Open source mantenido por la comunidad | Buen descubrimiento automático, centrado en SNMP | Se queda corto en entornos muy heterogéneos |
| Grafana | Capa de visualización | Paneles de muy buena calidad | No recoge datos por sí mismo; necesita otras fuentes |
A los fabricantes les gusta destacar cuántas plantillas de monitorización incluyen. Y es una ventaja real cuando hay prisa por desplegar: un equipo compatible de serie se monitoriza en minutos. El problema es que cada plantilla tiene que actualizarse con cada nueva versión de firmware. Un catálogo enorme solo vale la pena si el fabricante tiene recursos para mantenerlo al día.
Con la arquitectura pasa lo mismo. Una herramienta que funciona en un simple PC va de maravilla para una sede con unos cientos de equipos. Pero una red repartida entre varios países necesitará recolectores distribuidos, alta disponibilidad y una consola central capaz de aguantar todo ese volumen.
Además, muchas funciones que se dan por hechas no vienen incluidas. El análisis de NetFlow, las copias y comparativas de configuración, la gestión de direcciones IP o la monitorización wifi se venden muchas veces por separado. Dos ofertas al mismo precio pueden incluir cosas muy diferentes.
Las comparativas de funcionalidades solo llegan hasta cierto punto. En la práctica, que una herramienta funcione o no depende sobre todo de que encaje con el equipo que la va a gestionar.
Lo primero es mirar qué conocimientos hay en casa. Una solución open source muy potente puede convertirse en un quebradero de cabeza si nadie tiene tiempo de mantenerla. Lo segundo, la integración: la herramienta tiene que hablar con el sistema de tickets, con el SIEM y, si lo hay, con la plataforma de hipervisión. Después hay que pensar en el volumen de datos dentro de tres o cinco años, en poder gestionar los permisos con detalle y en ofrecer vistas claras para perfiles distintos. Un operador del turno de noche, un responsable de red y un director de operaciones no necesitan ver lo mismo.
Aquí es donde un integrador que no depende de ningún fabricante aporta algo distinto. Puede comparar varias soluciones en el entorno real del cliente, y no en una demo preparada sobre una red de laboratorio.
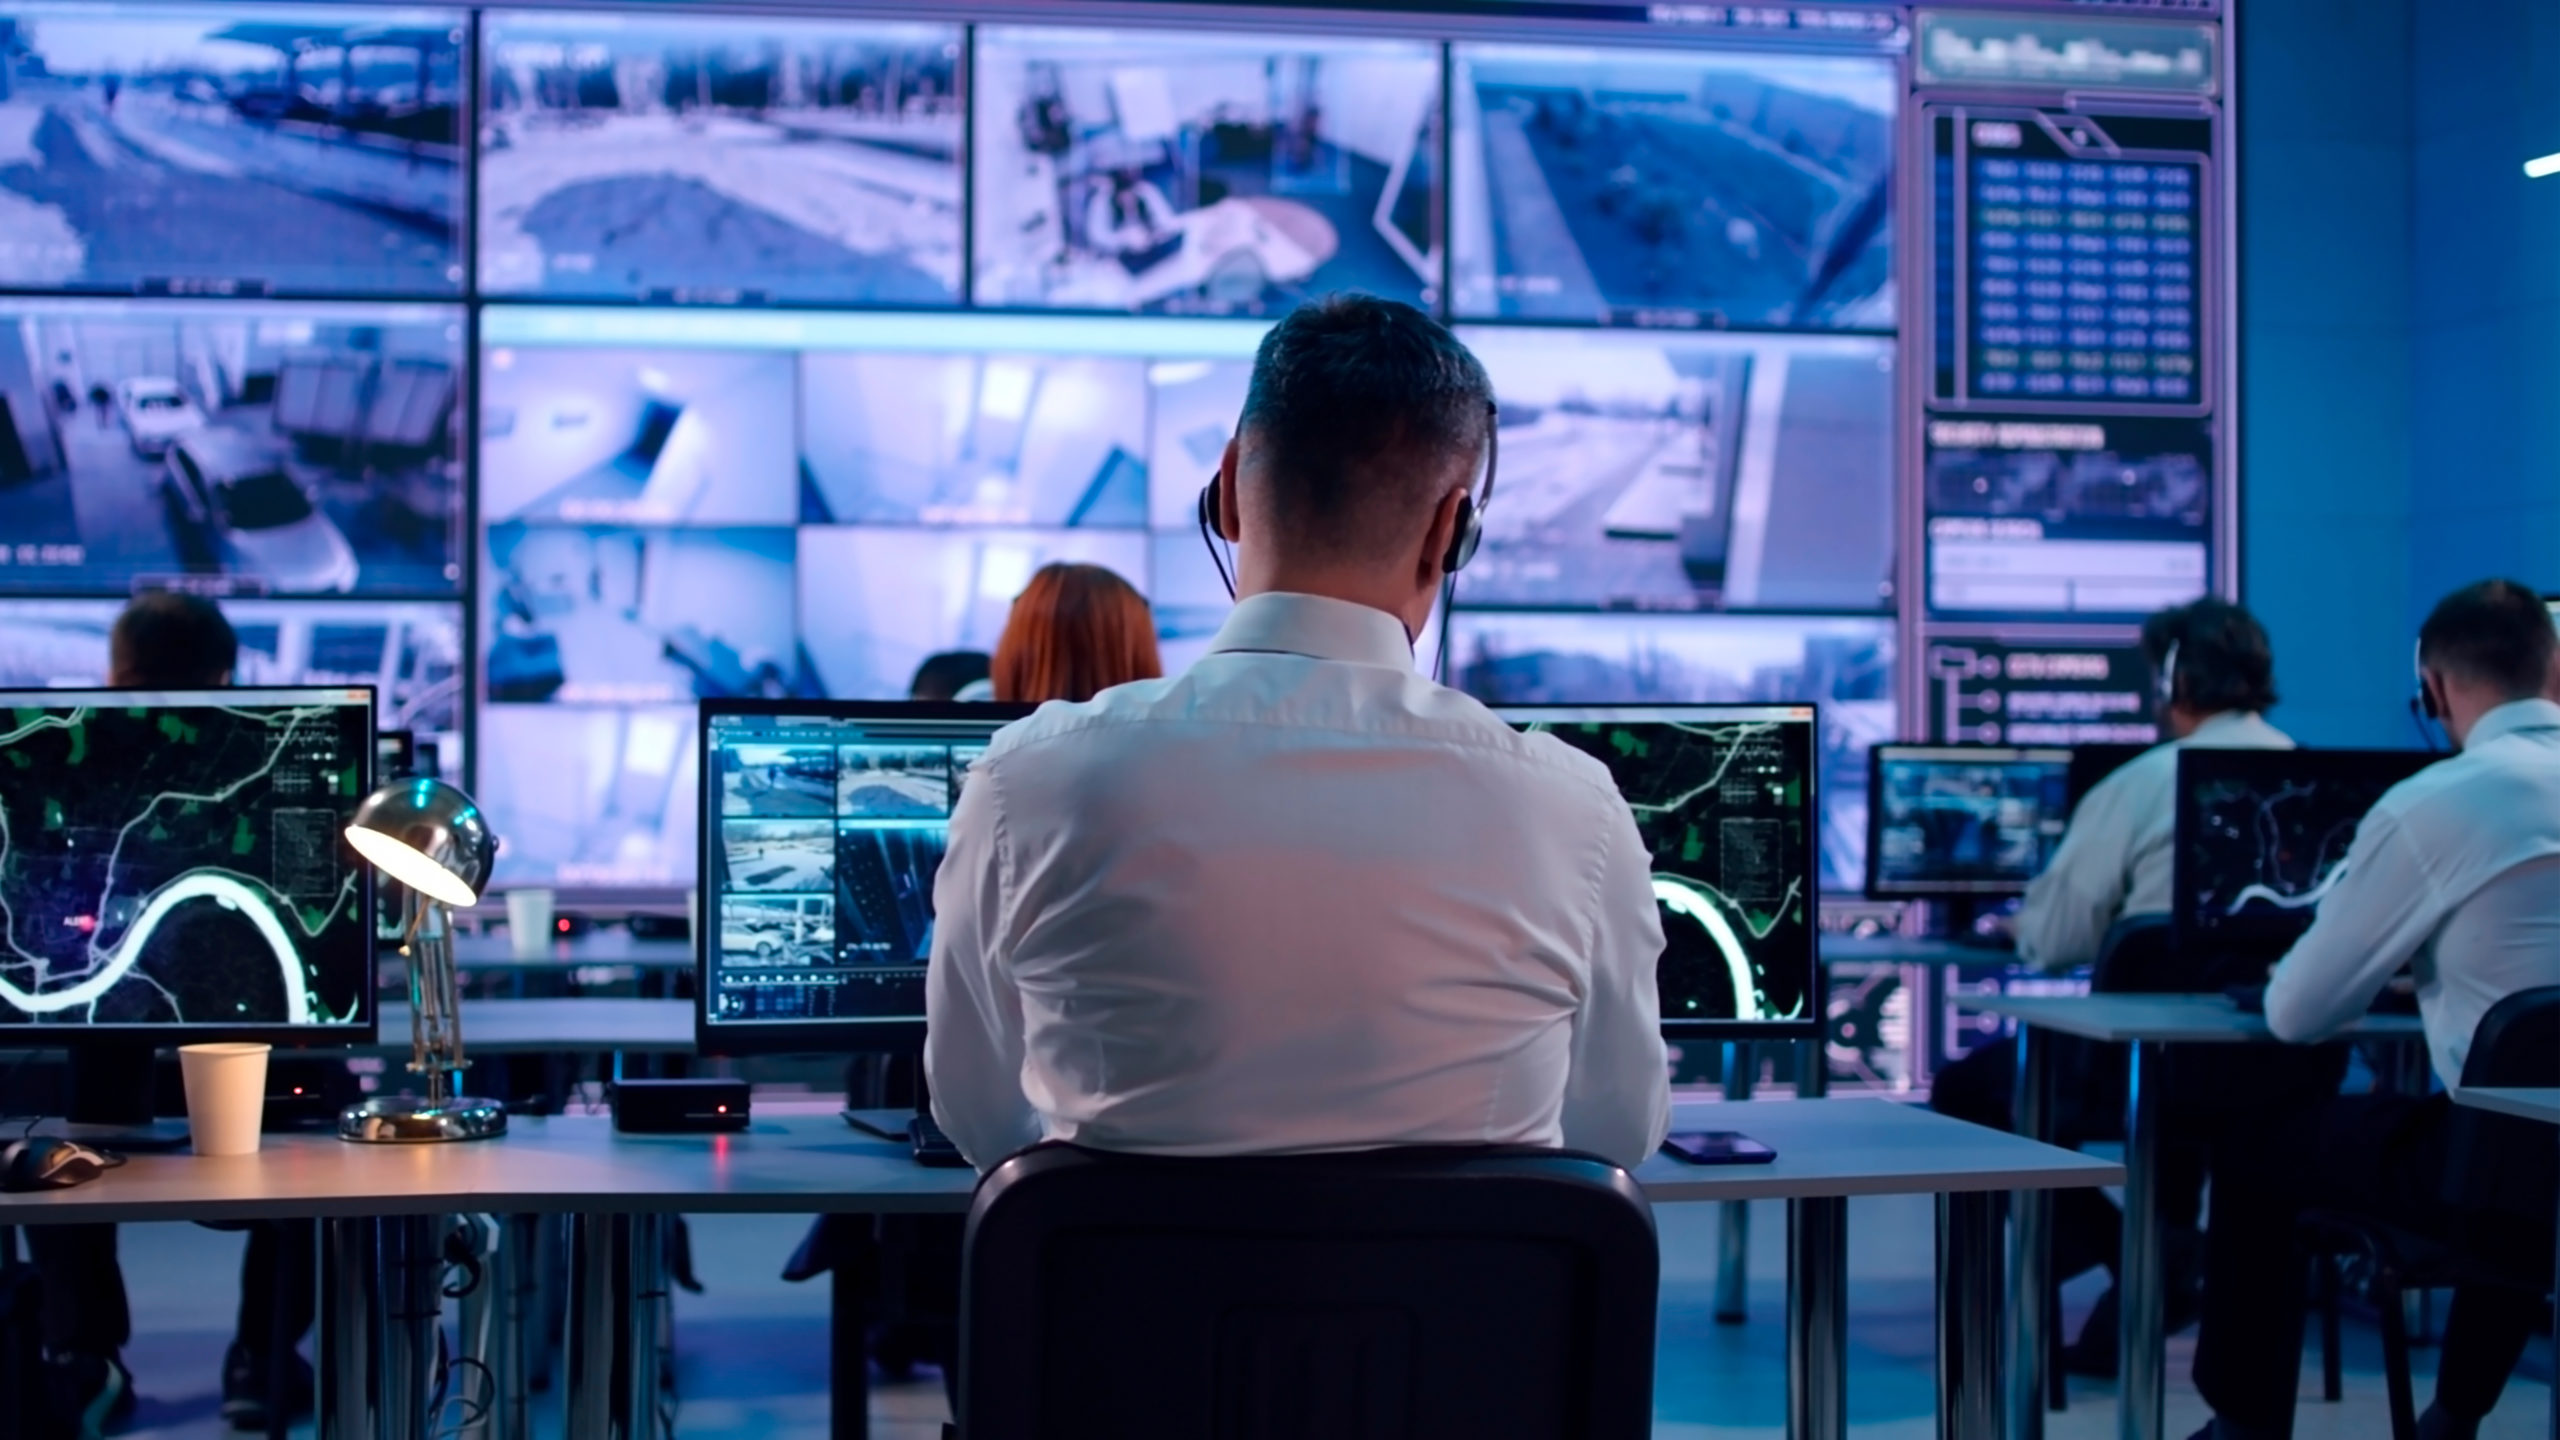
A partir de cierto tamaño, la monitorización se organiza en torno a un NOC (Network Operations Center, o centro de operaciones de red). Es donde los operadores vigilan la red, evalúan las incidencias y las escalan, muchas veces 24/7 en operadoras de telecomunicaciones, proveedores de hosting y grandes empresas.
Lo que hace que un NOC funcione no es tanto su equipamiento como sus procedimientos. Cada tipo de alerta tiene que tener asignada una criticidad, un responsable y un protocolo de actuación por escrito. Sin esas reglas, los operadores interpretan en lugar de actuar, y cada turno hace las cosas a su manera. Motilde acompaña este tipo de proyectos en centros de operaciones de red, telecomunicaciones e IT, desde la recogida de datos hasta el diseño de la propia sala.
La visualización se suele dejar para el final del proyecto, y es un error. Un videowall bien pensado hace que todo el equipo vea la misma situación al mismo tiempo.
Lo que mejor funciona es una regla muy simple: el videowall muestra la visión general y los puestos de operador, el detalle. En la pantalla grande, la cartografía, los servicios críticos y las alarmas activas; en cada puesto, las gráficas, los logs y las herramientas de diagnóstico. Poner cuarenta gráficas en una pared que se ve a seis metros queda muy vistoso para las visitas, pero no ayuda a nadie a tomar decisiones.
Un operador al final de su turno no reacciona igual que al empezarlo. La iluminación, la acústica, la distancia a las pantallas y la distribución de los puestos influyen directamente en su nivel de atención. La norma ISO 11064 regula estos aspectos en los centros de control, y sus recomendaciones encajan perfectamente en un NOC.
El otro gran enemigo es la fatiga por alarmas. Cuando alguien recibe cientos de avisos al día, acaba pulsando «reconocer» de forma automática. Y el día que llega la alerta importante, se pierde entre todas las demás. Por eso reducir el ruido no es solo una cuestión de comodidad, sino también de seguridad operativa.
Hay problemas que se repiten en una auditoría tras otra, da igual el sector. El más habitual es la monitorización que se instala y se olvida: se puso en marcha con un proyecto, nadie la ha vuelto a ajustar, sigue con los umbrales por defecto y todavía muestra en alerta equipos que se retiraron hace tiempo.
Le siguen muy de cerca fiarse demasiado del ping, no tener mapeadas las dependencias, guardar el histórico durante muy poco tiempo y acumular consolas. Un equipo que tiene que ir saltando entre cinco herramientas para diagnosticar una caída pierde un tiempo valiosísimo intentando reconstruir lo que una vista unificada le habría mostrado a la primera. Y las ventanas de mantenimiento también suelen gestionarse mal: si no se silencian las alertas de forma programada, cada intervención planificada desencadena una lluvia de avisos que no sirven para nada.
Los proyectos que salen bien tienen algo en común: se hacen poco a poco. Intentar abarcarlo todo desde el primer día casi siempre termina con una herramienta desbordada y un equipo quemado.
Lo primero es hacer un inventario realista de los equipos y, sobre todo, de los servicios de los que depende el negocio. Después hay que decidir qué merece una alerta y qué basta con guardar en el histórico. Solo entonces toca elegir la herramienta, a ser posible después de una prueba de concepto sobre una parte real de la red.
Lo mejor es desplegar por fases, empezando por el núcleo de red y las sedes más importantes. Las primeras semanas sirven para ajustar los umbrales a cómo se comporta realmente la red, teniendo muy en cuenta lo que dicen los operadores. A partir de ahí, una revisión periódica, por ejemplo cada trimestre, ayuda a quitar las alertas que ya no aportan nada y a incorporar los cambios de la infraestructura.
La inteligencia artificial está entrando poco a poco en las herramientas de monitorización. Lo que aporta hoy es menos espectacular de lo que se suele vender, pero resulta muy práctico: detecta comportamientos fuera de lo normal sin necesidad de umbrales fijos, agrupa alertas relacionadas y apunta a la causa más probable. No viene a sustituir al operador, sino a quitarle trabajo de clasificación para que pueda centrarse en resolver. En esa línea se sitúan los enfoques de supervisión con IA.
La frontera entre la monitorización de redes, la de aplicaciones y la ciberseguridad es cada vez más difusa. Una lentitud puede venir de un enlace saturado, de una base de datos sobrecargada o de un ataque en curso. Por eso cada vez más organizaciones cruzan estas fuentes de datos, y algunas incluso juntan físicamente su NOC y su SOC.
Con tantas herramientas conviviendo, la hipervisión gana terreno. Permite pensar en los servicios que se prestan, no en los equipos. Ya no se trata de saber si un switch está en alerta, sino de comprobar si la facturación funciona en todas las sedes.
Los fabricantes están extendiendo la telemetría en streaming, que envía los datos prácticamente en tiempo real. Las microsaturaciones, que durante años pasaban desapercibidas, por fin se pueden medir. Eso sí, este cambio va a exigir mucha más capacidad de almacenamiento y de procesamiento de la que tienen hoy la mayoría de plataformas.
La monitorización de redes se ocupa de los equipos y del tráfico de comunicaciones: routers, switches, cortafuegos y enlaces de operador. La monitorización IT es más amplia e incluye también servidores, sistemas operativos, bases de datos y aplicaciones. Ambas suelen compartir herramientas, pero no los mismos indicadores ni los mismos conocimientos.
No hay uno que sea el mejor en todos los casos. Entre las soluciones comerciales, SolarWinds, ManageEngine OpManager, WhatsUp Gold y PRTG están entre las más utilizadas. En el lado open source, Centreon, Checkmk, Zabbix y Nagios tienen mucha presencia. La elección dependerá del número de equipos, del tipo de licencia que se prefiera, de la arquitectura que haya que monitorizar, de los conocimientos del equipo y de las integraciones que se necesiten.
Sí, y con más motivo, porque una pyme rara vez tiene un equipo de informática grande. Detectar un problema antes de que pare la actividad tiene todavía más valor. Muchas veces basta con una monitorización sencilla, centrada en unos pocos indicadores críticos, para evitar las interrupciones más costosas.
SNMPv3 sigue siendo el estándar para consultar los equipos de forma segura. Normalmente se combina con NetFlow o IPFIX para analizar el tráfico y con Syslog para los registros de eventos. En las infraestructuras más modernas, la telemetría en streaming ofrece mucha más precisión.
Hay tres medidas que funcionan rápido: ajustar los umbrales a cómo se comporta realmente cada equipo, configurar las dependencias para que solo salte la alerta de origen y programar las ventanas de mantenimiento. Revisar las reglas de vez en cuando con los operadores termina de redondearlo.
Puede ser una buena opción cuando no es viable mantener una vigilancia 24/7 con personal propio. Eso sí, requiere acuerdos de nivel de servicio muy claros y acceso compartido a los datos. Muchas organizaciones apuestan por un modelo mixto: su propio equipo durante el día y un proveedor externo por las noches y los fines de semana.
Una buena monitorización de redes se sostiene sobre tres pilares: datos fiables, una herramienta que encaje con el entorno y una organización pensada para quienes trabajan con ella cada día. Basta con que falle uno para que todo se tambalee, por muy bueno que sea el software.
El sector avanza rápido. Gracias a la IA, a la telemetría en tiempo real y a la hipervisión, la monitorización de redes está pasando de apagar fuegos a anticiparse a ellos. Las organizaciones que refuercen ahora sus bases serán las que mejor sepan aprovechar lo que viene.
Copyright © 2026. MOTILDE. All rights reserved.