Netzwerke fallen selten aus heiterem Himmel aus. Fast immer gibt es Vorboten, nur sind sie unscheinbar: CRC-Fehler, die sich auf einem Port häufen, eine WAN-Strecke, die dauernd am Anschlag läuft, ein Switch, dessen Speicher seit drei Wochen schleichend volläuft. Ein gutes Netzwerk-Monitoring macht solche Anzeichen rechtzeitig sichtbar, damit das Team reagieren kann, bevor es kracht. So weit die Theorie. In der Praxis haben viele Unternehmen zwar ein ordentlich eingerichtetes Monitoring-Tool, erfahren von Störungen aber trotzdem erst, wenn ein genervter Anwender anruft.
Das Wichtigste in Kürze
Netzwerk-Monitoring bedeutet, Zustand und Leistung der Kommunikationsinfrastruktur rund um die Uhr zu überwachen. Router, Switches, Firewalls, WLAN-Access-Points, Providerleitungen: Alles, worüber Daten laufen, fällt darunter.
Dieser Rahmen ist in den letzten zehn Jahren spürbar gewachsen. Ein Mittelständler muss heute seine SD-WAN-Strecken, Cloud-Tunnel und Remote-Zugänge im Auge behalten, manchmal zusätzlich noch das Produktionsnetz. In einer Fabrik oder an einem Hafenterminal überwacht derselbe Operator unter Umständen ein Ethernet-Backbone und gleichzeitig OT-Komponenten, bei deren Entwicklung niemand an Monitoring gedacht hat. Genau da wird es in vielen Projekten knifflig.
Die Begriffe werden oft durcheinandergeworfen, obwohl sie Unterschiedliches meinen. In Lastenheften führt das schnell zu Missverständnissen.
Einfaches Monitoring misst Werte und vergleicht sie mit Schwellenwerten. Supervision, ein Begriff, der vor allem im Leitwartenumfeld verbreitet ist, geht einen Schritt weiter: Sie löst Alarme aus, speichert Verläufe und hilft bei der Fehlersuche. Observability will verstehen, warum sich ein System so verhält, wie es sich verhält, und verknüpft dafür Metriken, Logs und Traces. Hypervision setzt noch eine Ebene höher an: Sie fasst mehrere Monitoring-Tools in einer gemeinsamen Sicht zusammen, die sich an Geschäftsprozessen orientiert. Häufig ist in diesem Zusammenhang auch vom „Manager of Managers“ die Rede.
In großen Organisationen laufen alle vier Ebenen parallel. Es geht also nicht um ein Entweder-oder, sondern darum, für jede Frage die passende Ebene zu kennen.
Lange galt Netzwerk-Monitoring als reines Technikthema. Aktuelle Zahlen zeigen, warum inzwischen auch die Geschäftsleitung genauer hinschaut.
New Relic beziffert die Kosten eines schweren Ausfalls auf im Median 2 Millionen US-Dollar pro Stunde, das sind rund 33.333 US-Dollar pro Minute (Quelle: New Relic, 2025 Observability Forecast). Mindestens ebenso interessant: Unternehmen mit vollständiger Observability halbieren diese Kosten und erkennen Störungen 7 Minuten früher, bei einer durchschnittlichen Erkennungszeit von 28 Minuten (Quelle: New Relic). Wenn jede Minute Stillstand Geld kostet, sind sieben Minuten eine Menge.
Bei Rechenzentren zeigt sich ein ähnliches Bild. Laut Uptime Institute gaben 54 % der Befragten an, dass ihr letzter größerer Ausfall mehr als 100.000 US-Dollar gekostet hat, bei jedem Fünften waren es sogar über eine Million (Quelle: Uptime Institute, Annual Outage Analysis 2025).
Wie derselbe Bericht zeigt, haben IT- und Netzwerkprobleme 2024 als Ausfallursache zugelegt und standen hinter 23 % der Ausfälle mit spürbaren Auswirkungen (Quelle: Uptime Institute). Die Autoren sehen den Grund in der zunehmenden Komplexität, durch die Konfigurationsfehler und unsauber umgesetzte Änderungen häufiger werden.
Wer im IT-Betrieb arbeitet, kennt solche Situationen nur zu gut. Jemand passt eine Firewall-Regel an oder spielt am Freitagabend noch schnell ein Firmware-Update ein, und plötzlich kommt ein ganzer Standort nicht mehr an eine wichtige Anwendung. Ein sauber eingestelltes Monitoring verhindert solche Fehler zwar nicht, sorgt aber dafür, dass sie deutlich schneller auffallen.
Mit der NIS2-Richtlinie (EU) 2022/2555 müssen deutlich mehr Organisationen als bisher Cybersicherheitspflichten erfüllen. Dazu zählt die Meldung erheblicher Sicherheitsvorfälle: eine Frühwarnung innerhalb von 24 Stunden, gefolgt von einer ausführlichen Meldung innerhalb von 72 Stunden. Ohne belastbare, zeitgestempelte und ausreichend lange aufbewahrte Netzwerkdaten sind diese Fristen kaum zu schaffen.
Am Anfang steht die Datenerfassung. Der Ping ist nach wie vor das erste Mittel der Wahl, beantwortet aber nur eine Frage: Antwortet das Gerät? Ob eine Leitung überlastet ist oder ein Dienst langsam in die Knie geht, erfährt man dadurch nicht.
Die eigentliche Arbeit übernimmt SNMP, mit dem sich die internen Zähler der Geräte abfragen lassen. Zwei Punkte sollte man dabei unbedingt beachten. Erstens: auf SNMPv3 umsteigen, denn nur diese Version verschlüsselt und authentifiziert die Kommunikation. Bei Audits tauchen immer noch „public“-Communities auf, die seit Jahren unverändert aktiv sind. Zweitens: auf schnellen Interfaces 64-Bit-Zähler nutzen. Auf einer 10-Gbit/s-Strecke läuft ein 32-Bit-Zähler binnen Sekunden über, und die Traffic-Kurven sind damit wertlos.
Um zu sehen, wer die Bandbreite eigentlich verbraucht, braucht es zusätzlich eine Flow-Analyse über NetFlow, IPFIX oder sFlow. Syslog rundet das Ganze ab und ist unverzichtbar, wenn man im Nachhinein rekonstruieren muss, wie es zu einer Störung kam. Neuere Geräte schicken ihre Daten außerdem per Streaming-Telemetrie fortlaufend selbst, und zwar in einer Auflösung, an die keine zyklische Abfrage herankommt.
Ein Klassiker unter den Fehlern: alles überwachen wollen. Heraus kommen überfrachtete Dashboards, auf die niemand mehr richtig schaut.
Erfahrene Teams machen es umgekehrt. Sie fangen mit dem Wesentlichen an, also der Verfügbarkeit kritischer Geräte und Dienste, der Leitungsauslastung, Latenz und Paketverlust. Bald danach kommen Interface-Fehler hinzu. Sie sind oft das erste Indiz für ein beschädigtes Kabel, ein schwächelndes optisches Modul oder einen falsch eingestellten Duplex-Modus. Bei Sprache und Video steht Jitter ganz oben auf der Liste. Eine Videokonferenz kann unbrauchbar werden, obwohl die Leitung gerade einmal zur Hälfte ausgelastet ist.
Vorsicht auch bei Durchschnittswerten, sie führen leicht in die Irre. Fragt man nur alle fünf Minuten ab, sieht eine Leitung womöglich nach entspannten 40 % aus, obwohl sie durch Microbursts von wenigen Sekunden immer wieder dichtmacht. Die Anwender klagen, dass alles hängt, die Kurven bleiben grün, und jeder schiebt den Schwarzen Peter weiter. Passen Messwerte und Nutzererfahrung so wenig zusammen, ist es höchste Zeit, das Monitoring auf den Prüfstand zu stellen.
Ein Alarm bringt nur etwas, wenn jemand darauf reagiert. Feste Schwellenwerte wie „80 % Auslastung“ sind schnell eingerichtet, erzeugen aber ebenso schnell jede Menge Rauschen. Liegt die Backup-Leitung jede Nacht um 2 Uhr bei 95 %, ist das keine Störung. So soll es sein.
Mindestens genauso wichtig ist die Korrelation. Fällt der Router an einem Außenstandort aus, sind auch die vierzig Geräte dahinter nicht mehr erreichbar. Sind keine Abhängigkeiten hinterlegt, bekommt der Operator einundvierzig Alarme. Sind sie hinterlegt, bekommt er genau einen, und zwar den, der zählt. Das setzt allerdings eine aktuelle Netzdokumentation voraus, und gerade die bleibt erfahrungsgemäß oft auf der Strecke.
Der Markt lässt sich grob in zwei Lager einteilen. Auf der einen Seite stehen kommerzielle Hersteller mit sehr umfangreichen Suiten, etwa SolarWinds, ManageEngine, Progress WhatsUp Gold oder Paessler PRTG. Auf der anderen Seite gibt es Lösungen aus der Open-Source-Welt wie Centreon, Checkmk, Zabbix oder Nagios, die meist eine kostenlose Edition und eine kommerzielle Variante mit Support anbieten.
Die wirklich großen Unterschiede liegen dabei oft woanders, als man vermuten würde. Einen Switch per SNMP abfragen kann jedes dieser Tools. Unterscheiden tun sie sich vor allem in Architektur, Funktionsumfang und darin, wie sie sich über Module erweitern lassen.
| Lösung | Profil | Stärken | Gut zu wissen |
|---|---|---|---|
| SolarWinds | Sehr umfassende Suite mit Ursprung im Netzwerkbereich | Tiefgehende Analyse (historische Karten, Netzwerkpfadanalyse, DPI), skaliert sehr gut, Module für NetFlow, Konfigurationsmanagement, IPAM und Port-Tracking | Viele Module, daher Budget und Architektur von Anfang an gut durchplanen |
| ManageEngine OpManager | ITOM-Suite von Zoho | Viele integrierte Module (NetFlow, Konfigurationen, Firewalls, Server), große Vorlagenbibliothek mit frei einstellbaren Schwellenwerten | Recht vollgepackte Oberfläche, die etwas Einarbeitung erfordert |
| WhatsUp Gold (Progress) | Auf einfache Bedienung im Alltag ausgelegt | Intuitive Drill-down-Navigation, Metriken lassen sich leicht testen, Module für NetFlow, Konfigurationen, Logs und WLAN | Deckt weniger Anwendungen ab als die großen Suiten |
| PRTG (Paessler) | All-in-one-Lösung, Lizenzierung nach Sensoren | Schnell installiert, Karten einfach erstellt, automatische Updates | Kosten wachsen mit der Zahl der Sensoren, Zusatzmodule weniger umfangreich |
| Lösung | Profil | Stärken | Gut zu wissen |
|---|---|---|---|
| Centreon | Französischer Hersteller, freie und kommerzielle Editionen | Riesige Auswahl an Konnektoren, stark in großen, verteilten Umgebungen | Fortgeschrittene Konfiguration ist anspruchsvoll |
| Checkmk | Deutscher Hersteller, freie und kommerzielle Editionen | Erkennt Services automatisch, bindet viele Geräte in kurzer Zeit ein | Eigene Konfigurationslogik, an die man sich erst gewöhnen muss |
| Zabbix | Komplett Open Source | Sehr umfangreich, keine Lizenzkosten, aktive Community | Steile Lernkurve |
| Nagios | Der Pionier, freie Version und kommerzielles Nagios XI | Über Plugins nahezu beliebig erweiterbar, Basis vieler anderer Tools | Altbackene Oberfläche, Konfiguration überwiegend von Hand |
| LibreNMS | Von der Community getragenes Open Source | Gute automatische Erkennung, stark auf SNMP ausgerichtet | Stößt in sehr heterogenen Umgebungen an Grenzen |
| Grafana | Visualisierungsschicht | Hervorragende Dashboards | Sammelt selbst keine Daten, braucht andere Quellen |
Hersteller werben gern mit der Zahl ihrer Monitoring-Vorlagen. Für einen schnellen Rollout ist das auch ein echter Pluspunkt, denn ein unterstütztes Gerät ist in wenigen Minuten eingebunden. Der Haken: Jede Vorlage muss mit neuen Firmware-Ständen gepflegt werden. Ein großer Katalog nützt nur dann etwas, wenn der Hersteller ihn auch dauerhaft aktuell halten kann.
Bei der Architektur lohnt es sich ebenfalls, genau hinzusehen. Ein Tool, das auf einem einfachen Rechner läuft, reicht für einen einzelnen Standort mit ein paar hundert Geräten völlig aus. Ein Netz, das sich über mehrere Länder erstreckt, verlangt dagegen nach verteilten Kollektoren, Hochverfügbarkeit und einer zentralen Konsole, die mit dem Datenaufkommen klarkommt.
Und noch etwas: Viele Funktionen, die man für selbstverständlich hält, sind gar nicht im Grundpaket enthalten. NetFlow-Analyse, Konfigurationssicherung und -vergleich, IP-Adressverwaltung oder WLAN-Monitoring werden häufig als eigene Module verkauft. Zwei Angebote zum gleichen Preis können deshalb einen völlig unterschiedlichen Leistungsumfang haben.
Funktionsvergleiche helfen nur bis zu einem gewissen Punkt. Ob ein Tool im Alltag funktioniert, hängt vor allem davon ab, ob es zu dem Team passt, das es betreiben soll.
Die erste Frage gilt dem vorhandenen Know-how. Eine leistungsstarke Open-Source-Lösung kann schnell zum Klotz am Bein werden, wenn niemand Zeit hat, sich darum zu kümmern. Die zweite Frage betrifft die Anbindung: Das Tool muss mit dem Ticketsystem, dem SIEM und gegebenenfalls der Hypervision-Plattform zusammenarbeiten. Dazu kommen das zu erwartende Datenvolumen in drei bis fünf Jahren, ein fein abgestuftes Rechtekonzept und übersichtliche Ansichten für unterschiedliche Zielgruppen. Ein Operator in der Nachtschicht, ein Netzwerkverantwortlicher und ein Betriebsleiter brauchen schließlich nicht dieselben Bildschirme.
Hier kann ein herstellerunabhängiger Integrator echten Mehrwert bieten. Er testet mehrere Lösungen unter realen Bedingungen beim Kunden und nicht in einer perfekt vorbereiteten Demo im Testlabor.
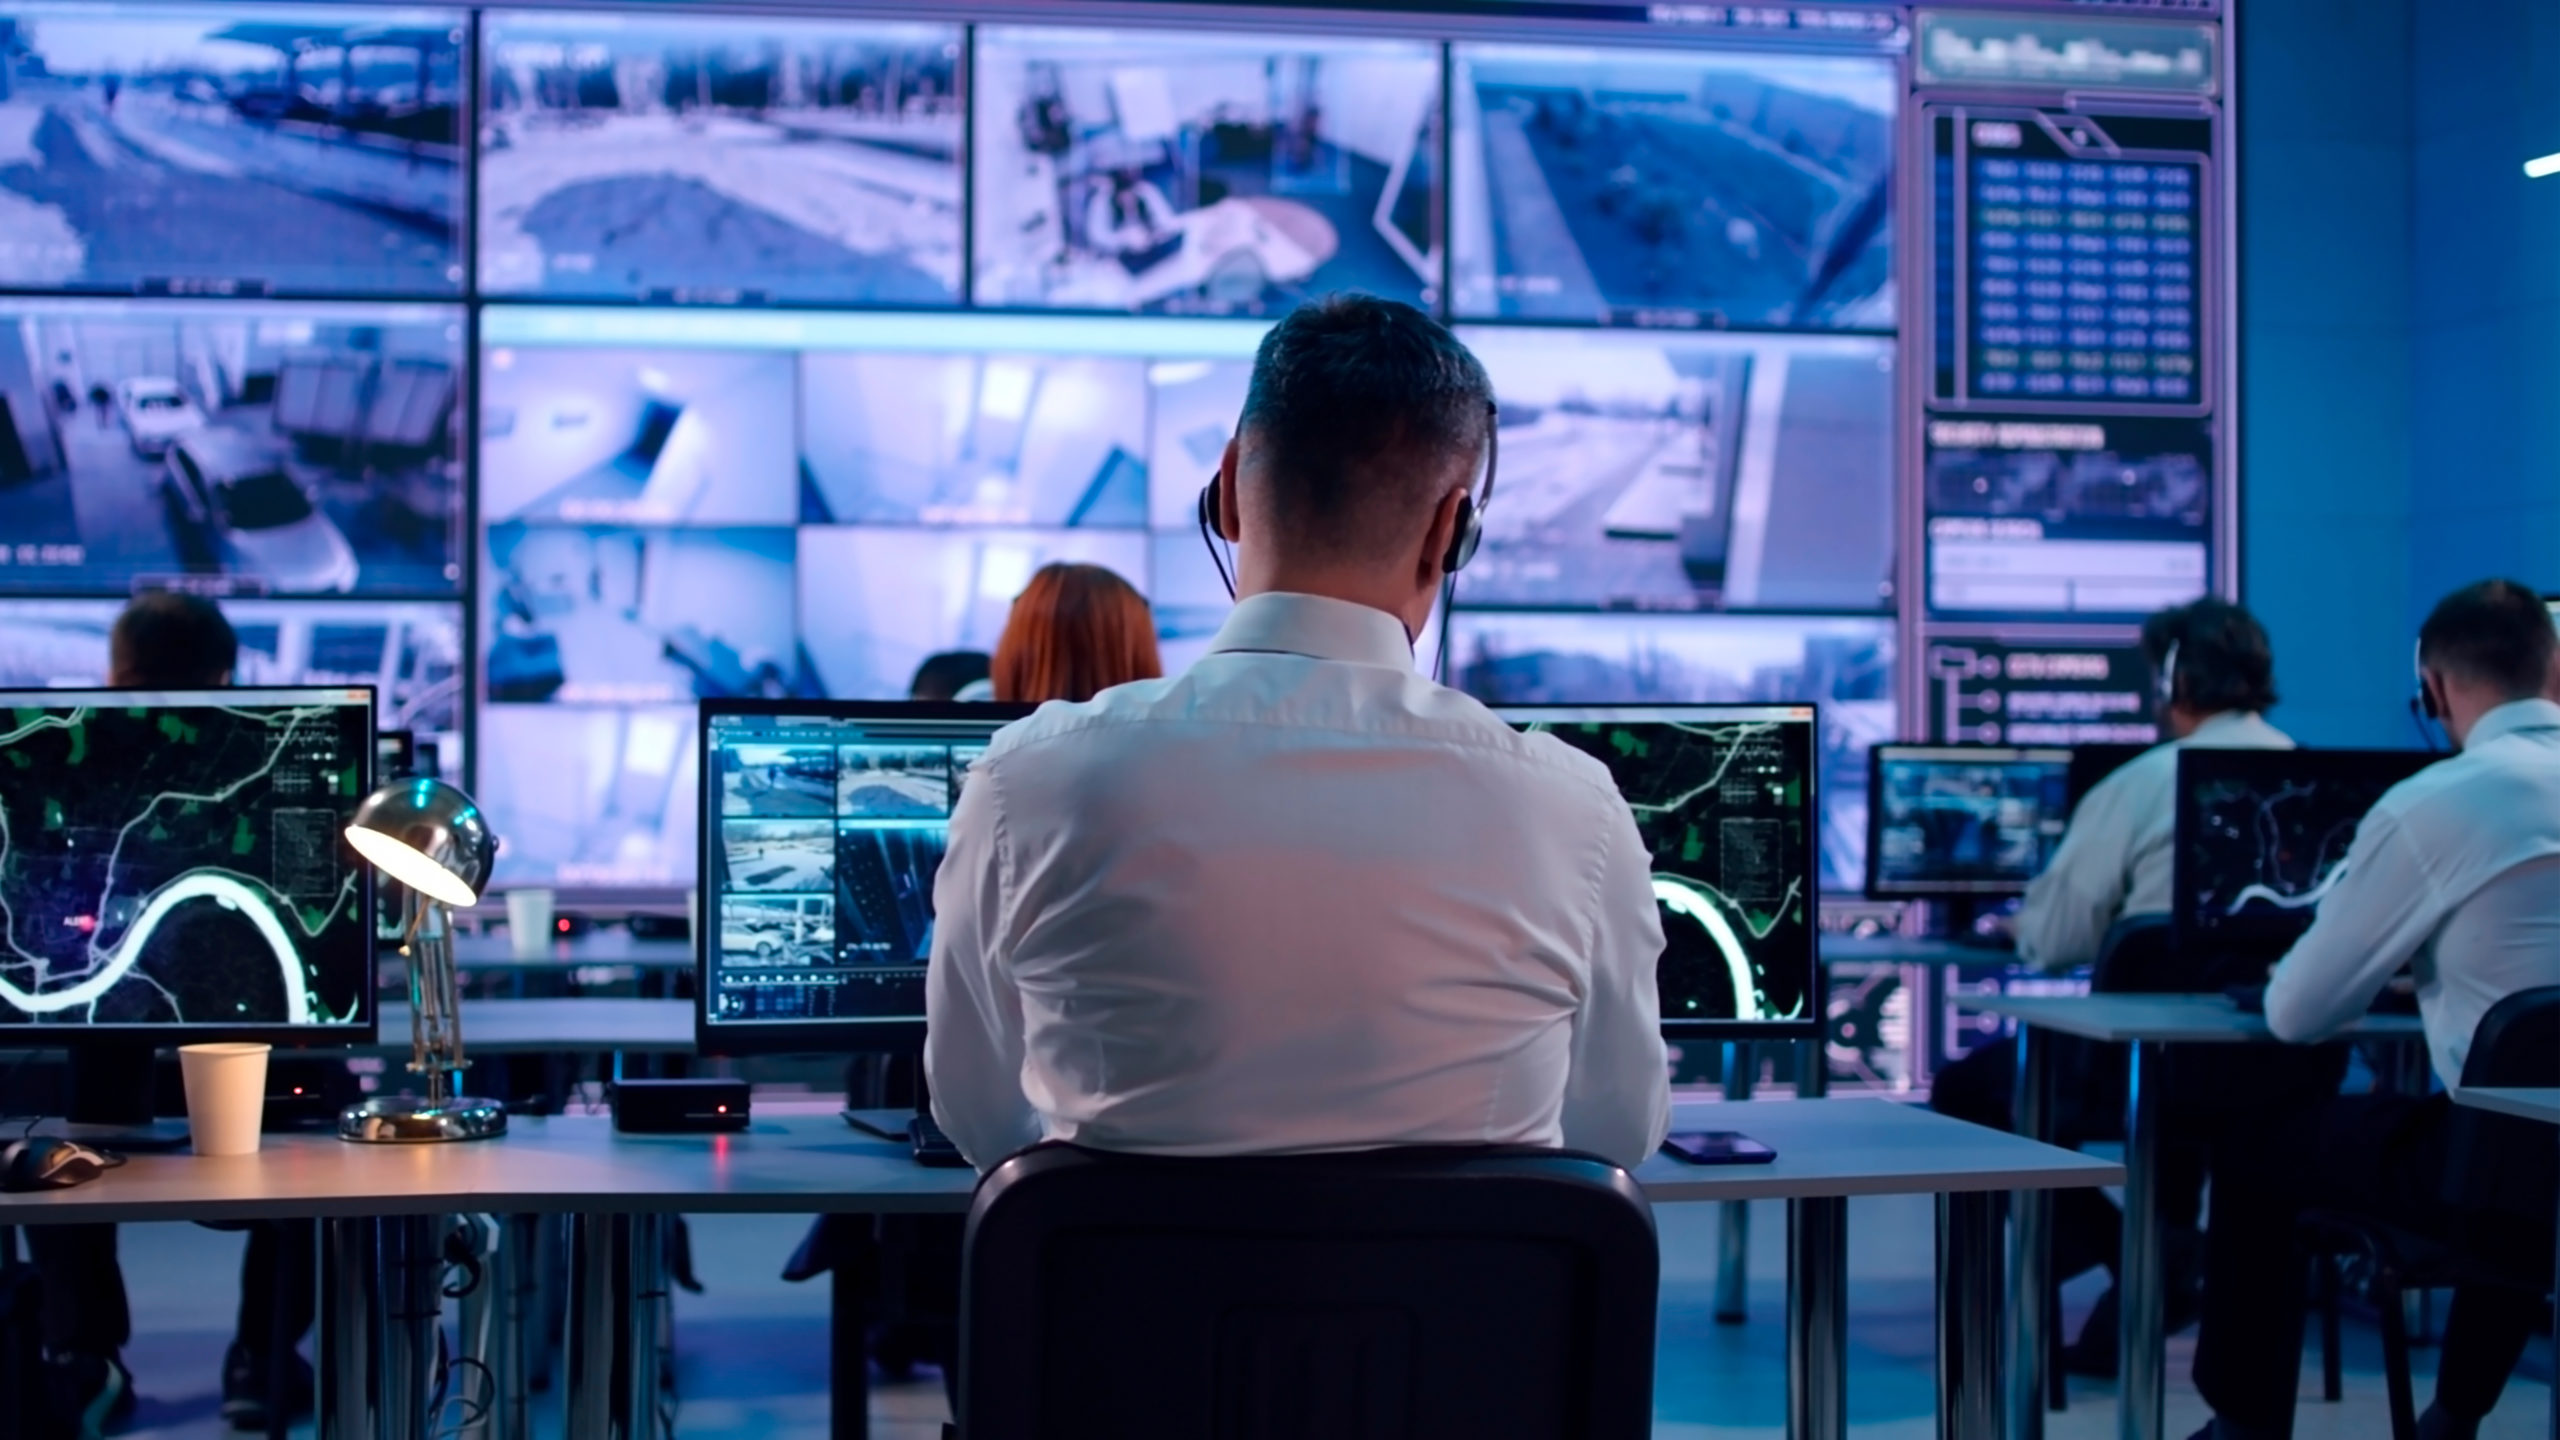
Ab einer bestimmten Größe läuft das Monitoring in einem NOC (Network Operations Center) zusammen. Dort überwachen Operatoren das Netz, bewerten Störungen und eskalieren sie bei Bedarf, bei Telekommunikationsanbietern, Hostern und Konzernen häufig im 24/7-Betrieb.
Ob ein NOC gut funktioniert, hängt weniger von der Technik ab als von den Abläufen. Jeder Alarmtyp braucht eine klare Priorität, einen Verantwortlichen und eine schriftlich festgelegte Vorgehensweise. Fehlen solche Regeln, fangen Operatoren an zu interpretieren, statt zu handeln, und jede Schicht macht es auf ihre Weise. Motilde unterstützt solche Projekte in Netzwerk-, Telekommunikations- und IT-Betriebszentralen, von der Datenerfassung bis zur Gestaltung des Raums.
Die Visualisierung kommt in vielen Projekten erst ganz zum Schluss dran, dabei gehört sie von Anfang an mitgedacht. Eine gut geplante Videowand sorgt dafür, dass alle im Raum im selben Moment dasselbe Lagebild vor Augen haben.
Bewährt hat sich eine einfache Faustregel: Die Videowand zeigt das große Ganze, die Arbeitsplätze der Operatoren die Details. Netzplan, kritische Dienste und aktuelle Alarme gehören an die Wand, Kurven, Logs und Diagnosewerkzeuge auf die Monitore am Platz. Vierzig Diagramme auf einer Wand, die man aus sechs Metern Entfernung betrachtet, machen bei Besuchern Eindruck. Weiterhelfen tun sie im Ernstfall niemandem.
Gegen Ende einer langen Schicht reagiert niemand mehr so wie zu Dienstbeginn. Licht, Akustik, Sichtabstand zu den Bildschirmen und die Anordnung der Arbeitsplätze haben direkten Einfluss darauf, wie aufmerksam jemand bleibt. Die ISO 11064 regelt genau diese Punkte für Leitwarten, und ihre Empfehlungen passen eins zu eins auf ein NOC.
Dazu kommt die Alarmmüdigkeit. Wer jeden Tag Hunderte Meldungen bekommt, klickt irgendwann nur noch aus Gewohnheit auf „Bestätigen“. Kommt dann der eine Alarm, der wirklich zählt, geht er im allgemeinen Grundrauschen unter. Weniger Lärm im System ist deshalb nicht nur angenehmer, sondern vor allem eine Frage der Betriebssicherheit.
Manche Muster begegnen einem bei Audits immer wieder, ganz gleich in welcher Branche. Ganz vorne liegt das Monitoring nach dem Motto „einmal einrichten und vergessen“: im Zuge eines Projekts aufgesetzt, danach nie wieder angefasst, mit Standard-Schwellenwerten und längst ausgemusterten Geräten, die noch immer rot leuchten.
Dicht dahinter folgen zu viel Vertrauen in den Ping, fehlende Abhängigkeiten, eine zu kurze Aufbewahrung der Verlaufsdaten und ein Wildwuchs an Konsolen. Muss ein Team bei einem Ausfall zwischen fünf Tools hin- und herspringen, verliert es wertvolle Zeit damit, sich zusammenzusuchen, was eine zentrale Ansicht auf einen Blick gezeigt hätte. Auch Wartungsfenster werden oft stiefmütterlich behandelt. Werden die Alarme dafür nicht gezielt stummgeschaltet, löst jeder geplante Eingriff eine Lawine überflüssiger Meldungen aus.
Erfolgreiche Projekte haben eines gemeinsam: Sie gehen in Etappen vor. Wer gleich am ersten Tag alles abdecken will, endet fast zwangsläufig mit einem überladenen Tool und einem entnervten Team.
Den Anfang macht eine ehrliche Bestandsaufnahme der Geräte und vor allem der Dienste, an denen das Geschäft hängt. Danach wird geklärt, was einen Alarm wert ist und was einfach nur mitprotokolliert werden muss. Erst dann geht es an die Auswahl des Tools, am besten nach einem Proof of Concept in einem echten Teil des Netzes.
Ausgerollt wird idealerweise schrittweise, beginnend mit dem Kernnetz und den wichtigsten Standorten. In den ersten Wochen werden die Schwellenwerte an das tatsächliche Verhalten angepasst, und dabei lohnt es sich, gut auf die Rückmeldungen der Operatoren zu hören. Später hilft eine regelmäßige Überprüfung, etwa einmal pro Quartal, dabei, nutzlos gewordene Alarme auszusortieren und Veränderungen in der Infrastruktur nachzuziehen.
Künstliche Intelligenz zieht nach und nach in Monitoring-Tools ein. Was sie heute konkret leistet, ist weniger spektakulär als die Werbeversprechen, aber im Alltag ausgesprochen nützlich. Sie erkennt Auffälligkeiten ohne feste Schwellenwerte, bündelt zusammengehörige Alarme und schlägt eine wahrscheinliche Ursache vor. Den Operator ersetzt sie damit nicht, sie nimmt ihm aber Sortierarbeit ab, damit er sich stärker um die eigentliche Fehlerbehebung kümmern kann. Genau darauf zielen Ansätze für KI-gestütztes Monitoring ab.
Die Grenzen zwischen Netzwerk-Monitoring, Anwendungsüberwachung und IT-Sicherheit werden immer durchlässiger. Ist eine Anwendung langsam, kann das an einer überlasteten Leitung liegen, an einer überforderten Datenbank oder an einem laufenden Angriff. Viele Organisationen führen diese Datenquellen deshalb zusammen, und manche bringen NOC und SOC sogar unter ein Dach.
Je mehr Tools im Einsatz sind, desto mehr gewinnt die Hypervision an Bedeutung. Mit ihr rücken die Services in den Mittelpunkt und nicht mehr die einzelnen Geräte. Statt „Ist dieser Switch im Alarm?“ lautet die Frage dann: „Läuft die Abrechnung an allen Standorten?“
Immer mehr Hersteller setzen auf Streaming-Telemetrie, die Daten nahezu in Echtzeit liefert. Microbursts, die jahrelang unter dem Radar blieben, lassen sich damit endlich messen. Der Preis dafür: Speicher- und Rechenbedarf steigen deutlich, und viele der heutigen Plattformen sind darauf noch nicht ausgelegt.
Netzwerk-Monitoring konzentriert sich auf die Kommunikationsinfrastruktur und den Datenverkehr, also auf Router, Switches, Firewalls und Providerleitungen. IT-Monitoring fasst den Rahmen weiter und schließt Server, Betriebssysteme, Datenbanken und Anwendungen mit ein. Häufig kommen dieselben Tools zum Einsatz, die Kennzahlen und das nötige Fachwissen unterscheiden sich aber deutlich.
Die eine beste Lösung für alle Fälle gibt es nicht. Unter den kommerziellen Produkten gehören SolarWinds, ManageEngine OpManager, WhatsUp Gold und PRTG zu den verbreitetsten. Im Open-Source-Bereich sind Centreon, Checkmk, Zabbix und Nagios stark vertreten. Welche Lösung passt, hängt von der Zahl der Geräte, dem bevorzugten Lizenzmodell, der zu überwachenden Architektur, dem Know-how im Team und den nötigen Schnittstellen ab.
Ja, gerade sie. KMU haben selten eine große IT-Abteilung, und umso wichtiger ist es, Probleme zu erkennen, bevor sie den Betrieb lahmlegen. Oft genügt schon ein schlankes Monitoring mit ein paar wenigen, aber entscheidenden Kennzahlen, um die teuersten Ausfälle zu vermeiden.
SNMPv3 ist nach wie vor der Standard für die sichere Abfrage von Geräten. Ergänzt wird es meist durch NetFlow oder IPFIX für die Analyse des Datenverkehrs und durch Syslog für Ereignisprotokolle. In modernen Infrastrukturen sorgt Streaming-Telemetrie für eine deutlich höhere Genauigkeit.
Drei Maßnahmen zeigen schnell Wirkung: Schwellenwerte an das tatsächliche Verhalten jedes Geräts anpassen, Abhängigkeiten hinterlegen, damit nur der ursächliche Alarm ausgelöst wird, und Wartungsfenster sauber einplanen. Wer die Regeln zusätzlich regelmäßig gemeinsam mit den Operatoren durchgeht, hat das Thema gut im Griff.
Das kann sinnvoll sein, wenn sich eine Überwachung rund um die Uhr mit eigenem Personal nicht stemmen lässt. Wichtig sind dann klar definierte Service Levels und ein gemeinsamer Zugriff auf die Daten. Viele Unternehmen setzen auf ein Mischmodell: tagsüber das eigene Team, nachts und am Wochenende ein externer Dienstleister.
Ein wirksames Netzwerk-Monitoring steht auf drei Säulen: verlässliche Daten, ein Tool, das zur Umgebung passt, und eine Organisation, die auf die Menschen zugeschnitten ist, die täglich damit arbeiten. Fehlt eine davon, wackelt das ganze Gebäude, ganz gleich, wie leistungsstark die Software ist.
Das Fachgebiet entwickelt sich rasant. Mit KI, Echtzeit-Telemetrie und Hypervision wandelt sich das Netzwerk-Monitoring vom Feuerlöschen zum vorausschauenden Handeln. Wer seine Grundlagen jetzt solide aufstellt, wird davon am stärksten profitieren.
Copyright © 2026. MOTILDE. All rights reserved.